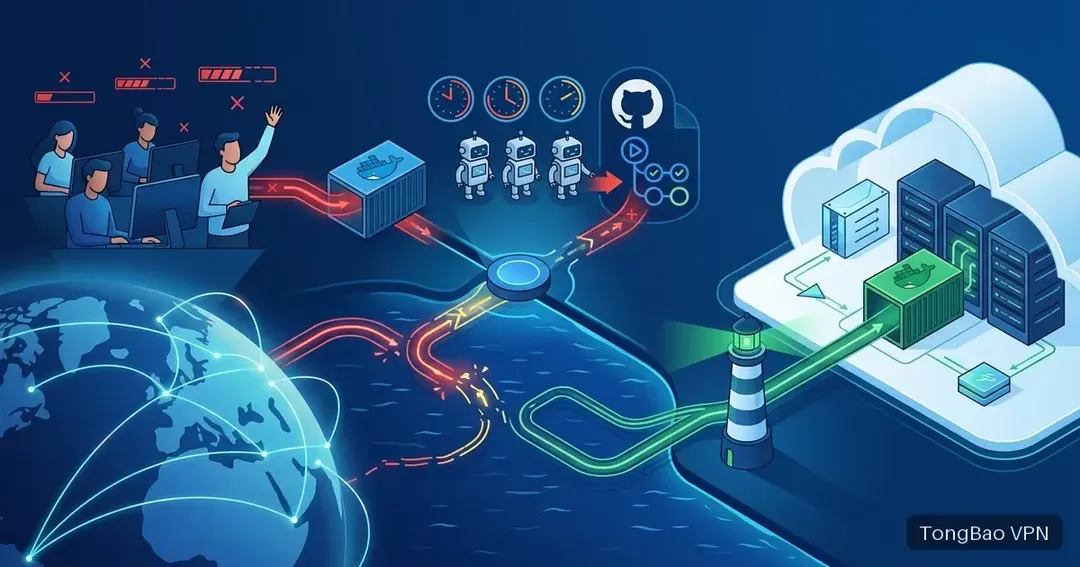
周五下午准备发版,流水线跑到第三步变红。打开日志,失败的并不是测试,而是拉取基础镜像时连接超时。重跑一次,镜像这一步过了,却卡在安装依赖阶段。第三次才完整跑通,从最初触发到结束已经过去四十分钟,原定发版后的验证工作全部往后顺延。
出海研发团队对这个场景应该不陌生。让人无奈的地方在于:代码一行没错,时间全花在等网络上。
一、出海研发团队在构建环节常撞上的问题
Docker 镜像拉取中断:docker pull 走到某一层停住不动,最后超时退出。同一个镜像换个时间拉可能就顺利过了。
依赖包下载超时:npm、pip、Maven、Go module 从公共仓库拉包,个别包卡住导致整个安装失败。
GitHub Actions 步骤超时:流水线里下载工具链、拉取缓存、推送产物的步骤耗时不稳定,偶发超时。
私有制品库访问不稳定:企业自建在海外的镜像仓库或制品库,国内开发机访问时上传下载都慢。
模型或大文件资源下载失败:项目依赖的模型权重、测试数据集等大文件,下载到一半中断。
代码仓库操作缓慢:clone 大仓库、push 大改动时进度条爬得很慢,甚至中途断开。
远程调试与端口转发不稳定:连着海外测试环境做远程调试,会话时不时掉线。
二、根本原因:构建链路是”大文件传输 + 多次串行依赖”
镜像和依赖都是大文件持续传输。一个基础镜像动辄几百 MB 到几个 GB,分层下载时每一层都是一次连续传输。传输时间越长,遇到链路波动的窗口就越大。这解释了为什么”总是断在最大的那一层”——不是那层有问题,是它暴露的时间最长。
构建过程是串行依赖链。拉镜像 → 装依赖 → 编译 → 打包 → 推送,任何一环失败,整条链就断了。单步成功率 95% 听起来不低,但五步串起来的整体成功率就只有 77% 左右。这就是”流水线经常莫名其妙红一次”的数学解释。
CI 环境没有本地缓存兜底。开发者本地有镜像层缓存、有依赖缓存,即使网络不好也常常感知不到。CI 每次从干净环境开始,把所有网络依赖都暴露出来了。
并发构建会互相抢带宽。团队规模上来之后,多条流水线同时跑,同时拉镜像和依赖,共享的出口带宽被瞬间打满,所有构建一起变慢。
私有制品库没有公共镜像源可用。公共依赖还能靠国内镜像源加速,企业自己部署在海外的私有仓库只能走国际链路,是最容易被忽略的瓶颈。
丢包对大文件传输的伤害是非线性的。传输协议遇到丢包会主动降速重传,1% 的丢包率可能让实际吞吐降到理论带宽的零头。这就是”带宽明明够,下载就是慢”的原因。
三、通宝VPN 的解决思路
IEPL 国际专线:运营商级国际专用线路,与公共国际流量物理隔离,延迟稳定在 40–60ms,丢包率低。对大文件的持续传输而言,低丢包比高带宽更关键,它直接决定实际吞吐能否跑满。
AI 智能路由:自动识别 AI 工具与主流开发平台的流量特征并择优路由。研发团队日常同时使用 AI 编程助手和代码托管平台,不同流量各走各的优化路径。
独享纯净 IP:非共享数据中心 IP,独享出口带宽。多条流水线并发构建时,带宽不必与外部流量争抢。
全平台覆盖:Windows / macOS / iOS / Android 全平台同步,开发者在公司台式机和外出的笔记本上,构建体验一致。
四、实操建议
第一,先定位失败发生在哪一步。构建日志里区分清楚是”下载阶段失败”还是”编译/测试失败”。前者是网络问题,后者才是代码问题。这个区分能省掉大量无效排查。
第二,能用镜像源的都配上。npm、pip、Maven、Go 的国内镜像源该配就配,能显著减少走国际链路的流量总量,把宝贵的链路资源留给必须走国际的部分。
第三,把镜像层做小、做稳。基础镜像固定版本并推到自建仓库,避免每次构建都从公共仓库拉大体积镜像。
第四,给关键步骤配置合理的重试。下载类步骤配置自动重试,能吸收掉大部分偶发抖动,但重试不该成为掩盖链路问题的借口。
第五,错峰安排全量构建。夜间全量构建、定时的依赖更新任务,尽量避开团队集中开发的时段。
第六,把构建成功率当成团队指标监控。如果流水线的一次通过率长期低于 90%,且失败集中在下载环节,那就是链路问题在持续消耗团队时间,值得优先解决。
五、简单对比
| 环节 | 普通公共国际出口 | 通宝VPN 办公专线 |
|---|---|---|
| 镜像拉取 | 大层中断,需多次重试 | 持续传输稳定 |
| 依赖安装 | 个别包超时导致整体失败 | 下载完整率高 |
| 流水线一次通过率 | 偶发红灯,靠重跑 | 通过率稳定 |
| 私有制品库 | 无镜像源可依赖,全程慢 | 专线直连,上传下载稳定 |
| 并发构建 | 互抢带宽,一起变慢 | 独享带宽,并发不劣化 |
| 远程调试 | 会话易掉线 | 长连接稳定 |
研发效率的敌人从来不是单次的慢,而是不确定性。当团队开始默认”红了就再跑一次”,流水线作为质量门禁的意义就已经被削弱了。