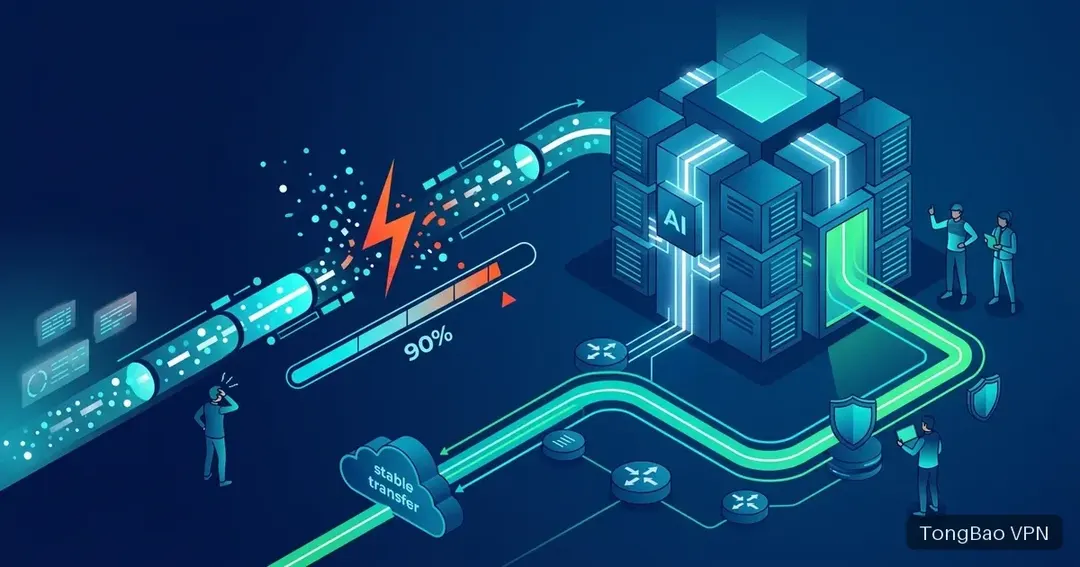
算法同事计划周三开始新一轮微调实验,周二下午就开始拉取模型权重。文件有十四个 G,进度条走到 12.8G 时断开,命令行提示连接被重置。重跑后这次断在 9G。第三次挂着跑了一夜,早上才完整下载下来,而周三上午原本要跑的对照组实验,又得重新排队等下载。
对 AI 团队来说,实验的节奏经常不是被算力卡住,而是被”东西还没下下来”卡住。
一、AI 研发团队在资源获取环节的常见问题
模型权重下载中断:几个 G 到几十 G 的权重文件,下到中途连接重置。
下载速度远低于带宽上限:办公室是千兆网络,实际下载速度只有几百 KB/s 到几 MB/s。
数据集拉取失败:训练数据集往往由大量小文件组成,批量拉取时个别文件失败导致整个流程报错。
依赖库和推理框架安装超时:安装深度学习相关的 Python 包时体积大,安装过程频繁超时。
在线推理接口调用不稳定:调用托管的推理服务时响应时间波动大,做效果对比测试时数据不可靠。
多人并发下载导致全组变慢:几个同事同时拉模型,办公室整体网络体验一起下滑。
容器镜像里打包模型时构建失败:构建包含模型文件的镜像时,下载步骤失败导致整个构建链断掉。
二、根本原因:AI 资源获取是”超大文件 + 长时间连接”的极端场景
大文件传输把链路稳定性的短板放大到极致。下载一个 200MB 的文件,链路只要在那两三分钟内稳定就行。下载 20GB,就需要链路在一两个小时里持续稳定。任何一次抖动都可能触发连接重置。这就是”总是断在后半段”的原因——不是文件损坏,是暴露时间足够长,问题必然出现。
丢包对吞吐的影响是非线性的。传输协议的拥塞控制机制在检测到丢包时会主动降低发送速率。在高延迟的跨境链路上,这个降速后的恢复过程特别慢。结果就是:链路的理论带宽是 100Mbps,但因为持续的低比例丢包,实际吞吐只能跑到几 Mbps。用户感受到的是”被限速了”,实际是丢包导致的自我降速。
数据集是大量小文件的批量传输。和单个大文件不同,数据集拉取是成千上万次小请求。这种模式对往返延迟极其敏感——每个文件都要经历一次完整的连接建立和传输过程,延迟高的时候总耗时会成倍增长。
AI 工具链的资源分布高度国际化。模型仓库、数据集、依赖包、容器镜像大多托管在海外,这条链路是 AI 研发绕不开的基础设施。
并发下载会把有限带宽切碎。团队里三个人同时拉大模型,每个人分到的实际带宽都不到理想值的三分之一,因为丢包和重传的开销会随并发放大。
三、通宝VPN 的解决思路
IEPL 国际专线:运营商级国际专用线路,与公共国际流量物理隔离。对大文件传输来说,最关键的指标不是峰值带宽,而是丢包率和链路稳定性。低丢包才能让传输协议跑满带宽,而不是在降速与重传之间反复消耗;40–60ms 的稳定延迟也能让数据集的批量小文件拉取更有效率。
AI 智能路由:自动识别 ChatGPT / Claude / Gemini 等 AI 工具的流量并优先择优路由。AI 团队日常既要下载模型,也要调用各类 AI 服务做对比评测,这些流量可以分别优化。
独享纯净 IP:非共享数据中心 IP,独享出口带宽。团队并发下载时带宽不与外部流量争抢。
全平台覆盖:Windows / macOS / iOS / Android 全平台同步,本地开发机和远程工作站的连接体验一致。
四、实操建议
第一,团队内建共享模型缓存。在内网服务器上维护一份统一的模型目录,配置好共享路径,避免同一个模型被重复下载多次。这是投入产出比最高的一步。
第二,用支持断点续传的工具。官方 CLI 工具通常已经支持,配置好本地缓存目录,中断后能从断点继续。
第三,把下载和实验解耦。不要在实验脚本里现下模型,提前一天把所需资源准备好,实验脚本只从本地加载。
第四,观察是丢包问题还是限速问题。如果下载速度长期远低于带宽且波动剧烈,多半是丢包导致的降速;如果速度稳定在某个固定值,才更像是服务端限速。
第五,数据集用打包形式获取。能拿到打包好的压缩包就不要逐文件拉取,一次大文件传输比几万次小请求高效得多。
第六,大规模下载安排在错峰时段。夜间下载不仅链路更空闲,也不会影响白天团队其他人的网络体验。
五、简单对比
| 场景 | 普通公共国际出口 | 通宝VPN 办公专线 |
|---|---|---|
| 大模型权重下载 | 频繁中断,需多次续传 | 长时间传输稳定完成 |
| 实际下载吞吐 | 丢包导致降速,远低于带宽 | 低丢包,吞吐接近带宽上限 |
| 数据集小文件批量拉取 | 高延迟成倍放大总耗时 | 低延迟,批量拉取高效 |
| 依赖安装 | 大包超时 | 安装稳定 |
| 并发下载 | 互抢带宽,整体劣化 | 独享带宽,并发可控 |
| 镜像构建含模型 | 下载步骤失败拖垮构建 | 构建链路稳定 |
AI 研发的迭代速度,取决于”想到一个思路”到”跑出第一版结果”之间的时间。如果这段时间里有一半花在等文件下载,团队的实验密度就上不去。