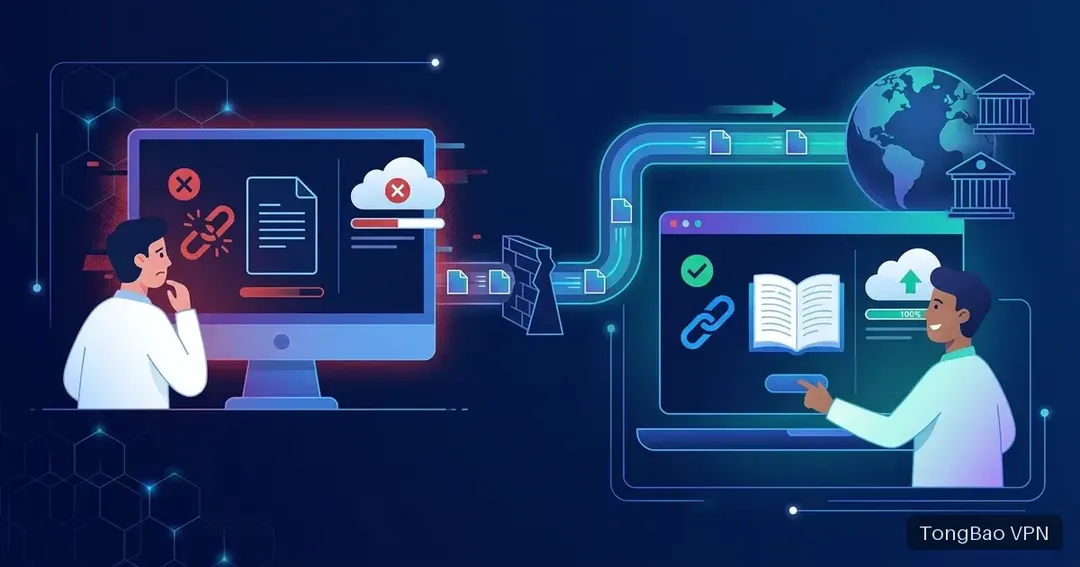
研究生撰写综述的第三周,检索出四百多篇相关文献并批量下载 PDF。下到一百多篇时发现有二十几个文件打不开,体积只有正常的几分之一。重新下载,又有十来个失败。投稿截止前的周末,补充材料是一个 180MB 的数据包,投稿系统上传三次都在中途断开,最后一次成功时距离截止只剩四十分钟。
科研和企业研发团队对国际学术资源的依赖是刚性的。这条链路不稳,损失的不只是时间,还有研究本身的完整性。
一、科研与研发团队常遇到的网络问题
文献数据库检索超时:检索请求提交后长时间无响应,或只返回部分结果。
PDF 下载中断或文件损坏:批量下载文献时部分文件不完整,打开报错。
投稿系统上传失败:手稿、图表、补充数据包上传中途中断。
同行评审平台访问不稳:审稿人查看稿件、提交评审意见时页面加载失败。
预印本平台提交超时:上传预印本时长时间处理后失败。
在线协作写作工具卡顿:多人协作撰写论文时同步延迟、公式编辑器响应慢。
科研数据集下载失败:公开数据集动辄几十 GB,下载中断率高。
代码与实验环境仓库访问慢:拉取论文配套的开源实现时速度极慢。
二、根本原因:学术资源访问是”批量下载 + 长任务提交”
文献批量下载是高频次的大文件传输。一篇 PDF 几 MB 到几十 MB,四百篇就是几个 GB,而且是几百次独立的下载请求。每一次都有失败的可能,累计下来必然有一批不完整。更麻烦的是失败往往是静默的——文件确实生成了,只是内容不全,不打开根本发现不了。
检索结果的分页加载会造成”看起来完整”的假象。系统性综述要求检索必须穷尽。如果因为链路问题只加载出前三页结果,研究者可能误以为相关文献就这么多——这直接影响研究结论的可靠性,是比”慢”严重得多的问题。
投稿系统的上传通常不支持续传。学术出版平台的技术栈普遍偏保守,大文件上传失败往往要从头开始。而投稿又有硬性截止日期,压力集中在最后几天。
数据集的体积是另一个量级。基因组数据、影像数据、大规模语料动辄几十上百 GB,对链路持续稳定性的要求接近极限。
评审和协作有时效要求。审稿有期限,多人协作写作有投稿节点,这些环节卡住会直接影响成果发表的时间线。
很多环节的失败是静默的。不完整的 PDF、缺失的检索结果、部分上传的材料,都不会主动报警。等发现时,往往已经基于残缺的信息做了一段工作。
三、通宝VPN 的解决思路
IEPL 国际专线:运营商级国际专用线路,与公共国际流量物理隔离,延迟稳定在 40–60ms、丢包率低。对批量文献下载而言,低丢包意味着文件完整率更高;对大体积数据集和投稿材料的上传,稳定的链路是长时间传输能够顺利完成的前提。
AI 智能路由:自动识别 AI 工具与主流平台的流量特征并择优路由。科研工作现在普遍借助 AI 工具做文献摘要、翻译和写作辅助,这部分流量与数据库访问流量各自优化。
独享纯净 IP:非共享数据中心 IP,独享出口带宽。实验室多人同时下载文献和数据集时不会互相拖垮。
全平台覆盖:Windows / macOS / iOS / Android 全平台同步,实验室工作站、笔记本、平板阅读文献的体验一致。
四、实操建议
第一,批量下载后做完整性校验。检查文件体积异常的项,或用脚本批量尝试打开 PDF。这一步能在综述写到一半之前就发现问题。
第二,检索时确认结果总数。留意数据库给出的命中总数,与实际加载出的条目数对比。数字对不上就说明加载不完整。
第三,投稿材料提前准备并提前提交。不要卡在截止日期当天上传大文件。提前两三天完成,出问题还有补救时间。
第四,补充材料尽量压缩到合理体积。能压缩的数据先压缩,能拆分的分成多个文件。单个文件越小,上传成功率越高。
第五,大数据集用支持续传的下载工具。命令行工具通常比浏览器直接下载更可靠,且支持断点续传。
第六,重要材料留本地备份。手稿、图表、数据包在本地保留完整副本,平台侧出问题时可以快速重新提交。
五、简单对比
| 场景 | 普通公共国际出口 | 通宝VPN 办公专线 |
|---|---|---|
| 数据库检索 | 结果加载不全,风险隐蔽 | 结果完整返回 |
| 批量文献下载 | 部分文件损坏 | 下载完整率高 |
| 投稿材料上传 | 大文件反复失败 | 一次上传成功 |
| 数据集获取 | 超大文件难以完成 | 长时间传输稳定 |
| 协作写作 | 同步延迟、编辑器卡顿 | 实时协作流畅 |
| 开源实现拉取 | 速度极慢 | 拉取顺畅 |
研究工作的严谨性,建立在信息获取的完整性之上。当检索、下载、提交这些基础环节都不可靠时,最上层的结论也就失去了可靠的基础。