一位海外客户在网站在线窗口里咨询退换货。客服看到消息,查完订单,打好回复点击发送,输入框一直转圈。八秒后消息才发出去,但客户已经在这八秒里连追两句“在吗?”“有人吗?”。会话结束后客户给了两星评价,理由是“响应太慢”。
跨境客服团队的服务质量指标,几乎每一项都和网络响应速度直接挂钩。这是少数几个”网络慢一点就直接反映在客户满意度上”的岗位。
一、跨境客服团队常遇到的网络问题
工单列表加载失败或不更新:打开工作台看到空列表或旧数据,新工单进来没有及时显示。
实时会话消息发送延迟:消息框转圈数秒才发出,客户端看到的是长时间沉默。
客户历史记录调取慢:点开客户档案想看历史订单和过往工单,加载要等好几秒。
宏、快捷回复、知识库插入卡顿:需要插入标准话术或帮助文档链接时,内容拉不出来。
附件收发失败:客户发来的截图打不开,客服要发的操作指引图片上传失败。
通话与语音客服质量差:如果同时承担电话客服,通话质量会直接受链路抖动影响。
工单状态更新丢失:改了优先级或指派人,刷新后又变回原样。
跨时区值班交接信息不同步:交接班时新班次看到的工单状态是旧的,造成重复跟进或漏跟进。
二、根本原因:客服工作台是”长连接 + 高频交互 + 时效敏感”的三重叠加
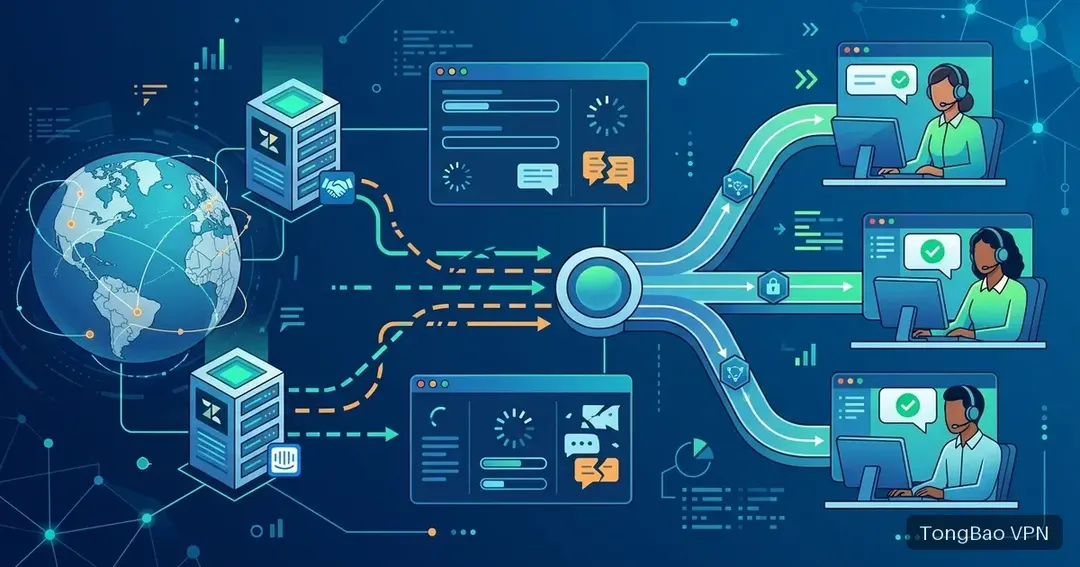
客服工作台依赖持续的长连接。新工单推送、客户消息实时到达、同事的内部备注、在线状态显示,都靠 WebSocket 这类长连接维持。链路不稳时长连接频繁断开重连,重连期间的消息可能延迟到达甚至需要靠刷新才能看到。这就是”工单列表不更新”的技术原因。
每一次交互的延迟都直接叠加到客户等待时间上。这是客服场景与其他办公场景最本质的区别:分析师等三秒只是自己不爽,客服等三秒是客户在屏幕另一头干等。一次会话里客服要做几十次操作——查订单、插话术、传附件、改状态——每次都慢一点,累计起来客户的等待感受会被显著放大。
响应时长是被量化考核的。首次响应时间、平均处理时长、满意度评分,这些指标全都受网络延迟直接影响。团队可能花大力气优化话术和流程,结果被链路吃掉了大部分收益。
跨时区值班意味着全天候依赖。客服团队通常覆盖多个时区的服务窗口,包括国内的深夜时段——而这正是公共国际出口最不稳定的时段之一。
多客服并发放大链路压力。十几个客服工作台同时维持长连接、同时高频操作,共享出口的压力在高峰期集中体现。
富媒体内容是隐藏的带宽消耗。客户发来的截图、录屏,客服发出的操作指引图,单个不大但全天累计可观。
三、通宝VPN 的解决思路
IEPL 国际专线:运营商级国际专用线路,与公共国际流量物理隔离,延迟稳定在 40–60ms。对客服场景,稳定的低延迟直接转化成更短的响应时间和更高的满意度评分——这是少数能把网络投入换算成业务指标的场景。
AI 智能路由:自动识别 AI 工具与主流办公平台的流量特征并择优路由。现在不少客服团队用 AI 工具做多语言翻译和回复草稿,这部分流量与工单系统的流量可以分别优化。
独享纯净 IP:非共享数据中心 IP,独享出口带宽。整个客服团队同时在线时,带宽不与外部流量争抢,避免高峰期整组一起变慢。
全平台覆盖:Windows / macOS / iOS / Android 全平台同步。值夜班的同事在家用笔记本、主管出门用手机看告警,连接体验一致。
四、实操建议
第一,给高优先级工单配独立告警渠道。不要只依赖工作台列表。配置邮件或即时消息告警,工作台加载失败时仍能收到通知。
第二,把首次响应时间拆开分析。如果团队的响应时间指标不达标,先区分是”客服没看到”还是”看到了但操作慢”。后者往往是网络问题,靠培训解决不了。
第三,常用话术做本地备份。把高频标准回复存一份在本地文档里,宏加载不出来时可以直接复制粘贴,不让客户干等。
第四,交接班时主动刷新确认。新班次接手前完整刷新一次工作台,确认看到的是最新状态,避免基于旧数据做跟进。
第五,附件类沟通提前准备。常用的操作指引图预先上传好并保存链接,需要时直接发链接而不是现场上传。
第六,把工作台响应速度纳入日常巡检。每天班次开始时做一次固定操作(比如打开一个工单再返回),记录耗时。这个简单动作能在客户投诉之前发现链路劣化。
五、简单对比
| 场景 | 普通公共国际出口 | 通宝VPN 办公专线 |
|---|---|---|
| 工单实时推送 | 长连接频繁断开,列表滞后 | 长连接稳定,工单即时到达 |
| 消息发送 | 转圈数秒,客户干等 | 秒发,会话节奏正常 |
| 客户档案调取 | 每次等待数秒 | 即点即开 |
| 宏与知识库 | 插入卡顿 | 内容快速加载 |
| 附件收发 | 上传失败需重试 | 传输稳定 |
| 多客服并发 | 高峰期整组变慢 | 独享带宽,并发不劣化 |
客服是公司离客户最近的岗位。这个岗位上的每一秒延迟,最终都会以评分、复购率和口碑的形式反馈回来。